<< 4.2 Когда искать нечего |
4.3 Ничего не исчезает бесследно |
5. WEB >> |
Говорят, в интернете ничто не иссчезает бесследно. Это высказывание, увы, неверно по очевидным причинам, но не так далеко от истины.
Действие I
Американская некоммерческая организация «Архив Интернета» почти четверть века занимается сохранением интернета и того контента, который когда-либо был в нём опубликован. Любой желающий может загрузить какой угодно файл, при условии, что это не нарушает ничьих авторских прав, и он будет храниться там столько, сколько будет техническая возможность его хранить. Но это не самое интересное. «Архив Интернета» знаменит своей программой Wayback Machine (англ. «машина времени»). Программа с 1996 года пытается обойти и заархивировать все существующие веб-страницы, и неплохо с этим справляется: на текущий момент в реестре зафиксировано 424 миллиарда страниц, причём, в отличие от кеша поисковых систем, Wayback Machine хранит для каждой страницы множество слепков, сделанных в разное время, позволяя наблюдать за изменениями.
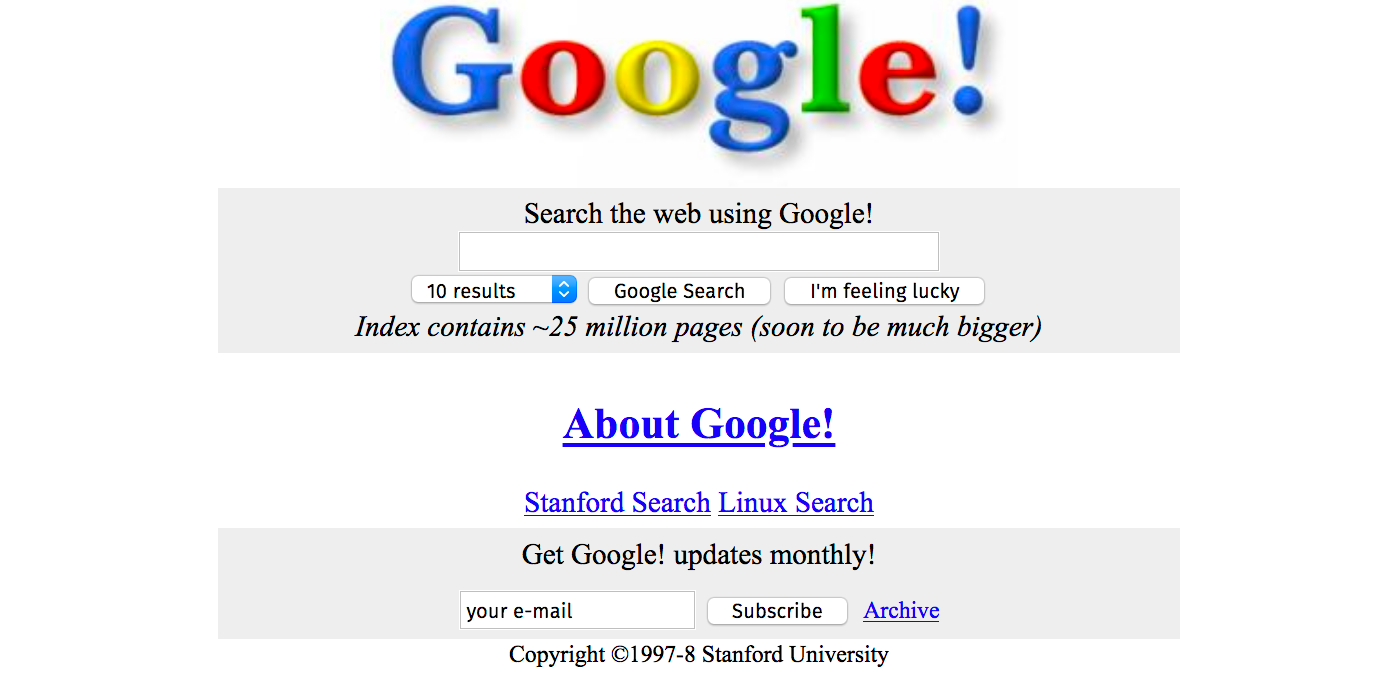 Google в ноябре 1998, спустя два месяца после открытия.
Эта «машина времени» интересна не только историкам, но и специалистам в сфере информационной безопасности. Иногда в слепки страниц попадает конфиденциальная информация, по неосторожности опубликованная нерасторопными администраторами сайтов. С течением времени, правда, такая информация всё чаще всплывает в социальных сетях, где полномочия «Архива Интернета», к сожалению, заканчиваются — их «машина времени» не индексирует.
Действие II
Wayback Machine — это робот. Так называют программы, которые бродят по интернету, собирая какие-нибудь данные в автоматическом режиме. Роботы есть у любой поисковой системы. Они заполняют индекс этих систем: именно так, например, «Яндекс» узнаёт о существовании сайтов. Роботы есть у спамеров: такие машины ищут сайты, на которых можно что-нибудь написать — ну, и пишут...
А ещё есть владельцы сайтов, которые не всегда хотят оказаться в архиве или поисковой выдаче просто потому, что им «повезло» оказаться на пути у какого-нибудь робота. Проблему решили так: договорились, что в корневой директории любого сайта может лежать файл robots.txt, который пишут люди и читают хорошие роботы, например:
User-agent: Yandex
Disallow: /картинки/

User-agent: Google
Disallow: /pictures/

User-agent: *
Disallow:
Такой файл указывает роботам «Яндекса» не индексировать все страницы внутри директории картинки, роботам Google — внутри директории pictures, и не устанавливает ограничений для любых других роботов. Конечно, такой файл — не панацея против спамеров и других злодеев, но даже хороший робот может причинить вред, совершая действия против воли человека. Файл robots.txt — способ этого избежать.
Для сокрытия данных в интернете есть множество других способов. О них — в следующей главе.
Иногда владельцы сайтов используют robots.txt, чтобы скрыть что-нибудь от посторонних глаз, видимо, не понимая, что это просто файл. Его может прочитать не только робот, но и любой человек, а затем воспользоваться знанием о «секретах» в своих интересах. Например, содержимое robots.txt у сайта "Библиотека Машкова":
User-Agent: *
Disallow: /~moshkow/book
Disallow: /win
Disallow: /koi
Disallow: /iso
Disallow: /mac
Disallow: /alt
Disallow: /lat
Disallow: /cgi-bin
Disallow: /LYNX
Disallow: /AQUARIUM
Disallow: /MPECHKIN
Disallow: /rk
Disallow: /Forum
Host: lib.ru
Некоторые социальные сети, например «ВКонтакте», позволяют пользователям самостоятельно выбирать, будет ли их страница индексироваться поисковыми системами. Поскольку пользователей много, все правила в robots.txt не добавить — получится файл из миллионов строк. Есть и другой способ влиять на поисковые системы: указывать на каждой странице специальный HTML-тег, разрешающий или запрещающий индексацию страниц. Например, запретить индексацию страницы можно так: <meta name="robots" content="noindex" />.
Действие III
Facebook может отказать в удалении страницы без причины, или сделать вид, что страница удалена, тихо восстановив её через неделю.
Компании, владеющие крупными социальными сетями, нередко не предоставляют возможности, скажем, удалить свой профиль или контент. Или предоставляют, но удаляют записи лишь из публичного каталога, не стирая сами данные. Так, например, делает «ВКонтакте»: любую «удалённую» из него фотографию можно открыть, если знать её URL (который, чести ради, практически невозможно подобрать — почти как в поговорке: «невозможно найти, легко забыть, но так же невозможно потерять»).
Соцсети сродни паутине, в которую ежедневно попадает неизмеримо большое количество информации всех видов. Нередко авторы публикаций даже не задумываются о персональных данных и последствиях.
Примечание
-
Паутина эта захватывает не только данные, но и пользователей. Удобно, когда друзья, события, товары, деньги, музыка, и всё на свете хранится в одном месте, а ещё связано удобным интерфейсом. Сейчас это принято называть экосистемой. Но за любое удобство надо платить.
-
Во-первых, бизнес-модель компаний вроде Facebook или «ВКонтакте» зиждится на рекламе, которую они могут показать своим пользователям. Со временем стало понятно, что её можно показывать эффективнее, когда известно поведение пользователей и можно нацеливать конкретные объявления на конкретных людей, а не на всех подряд. Если у вас есть аккаунт в любой крупной соцсети, то и у соцсети есть ваш аккаунт, содержащий психологический портрет и другие личные данные, которыми вряд ли бы вы стали делиться с кем-то, будь у вас явный выбор.
-
Во-вторых, идею об экосистеме с точки зрения информационной безопасности можно назвать единой точкой отказа. Доверять свои бесценные данные любой компании — не самая лучшая идея, ведь в тот момент, когда вы нажимаете кнопку Отправить, контроль над вашими данными переходит от вас к ним. Разумеется, они будут распоряжаться вашими данными лишь так, как им выгодно — ничего личного, просто бизнес!
Выводы
-
Wayback Machine — способ увидеть, как изменялась почти любая страница в интернете за последние 24 года.
-
У сайтов есть свои секреты. Сведения об их расположении могут храниться в файле
robots.txt. -
Социальные сети — неприступные крепости для внешнего интернета с сомнительной безопасностью.
Задача:
Ещё в далеких 2000-х для оптимизации работы сотрудников директор АгроКекСтроя закупил систему для работы сотрудников компании. Она находится где-то на поддомене их сайта.
Там лежит вся внутренняя документация холдинга, в том числе и чёрная бухгалтерия. Её-то вам и нужно найти.